让 AI 写周报,它想了 8 秒才挤出第一行;问它刚发生的新闻,它语气笃定,却把事实说得七零八落;把一份长合同交给它,读到后半段,前面记住的内容已经开始“掉线”。至于 AI 会员,月初用得兴起,月底一看,Token 消耗快赶上了话费。
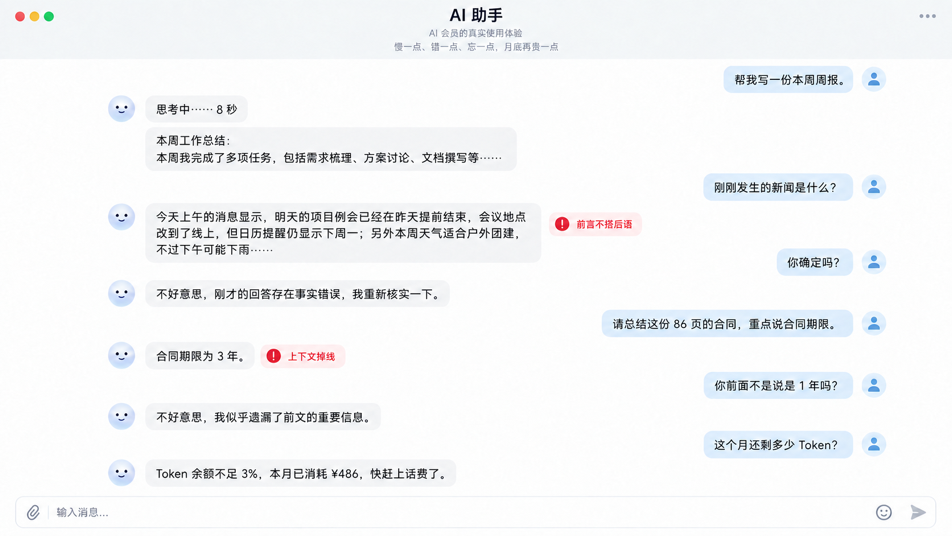
这些时刻很容易让人怀疑:是不是模型还不够聪明?
但一条请求从发出到返回,要经过等多个环节。就像点外卖时,就算餐厅、骑手都拉满了,但调度和配送路线规划等因素都可能影响最终体验。
于是,现在当 AI 开始进入办公、研发和各种真实业务,承担越来越多的工作,我们开始更关心它能不能随时调用、稳定运行,也让更多人用得起、持续用下去?
 给 AI 建一张能调度的“物流网”
这类问题并不只存在于某一种行业。随着 AI 规模化应用,算力开始同时面对供应链安全、数据合规和持续运营等要求。资源如何跨地域协同,模型如何在不同芯片之间顺畅运行,业务波动时如何及时扩缩容,都会影响 AI 能否真正进入日常工作流程。
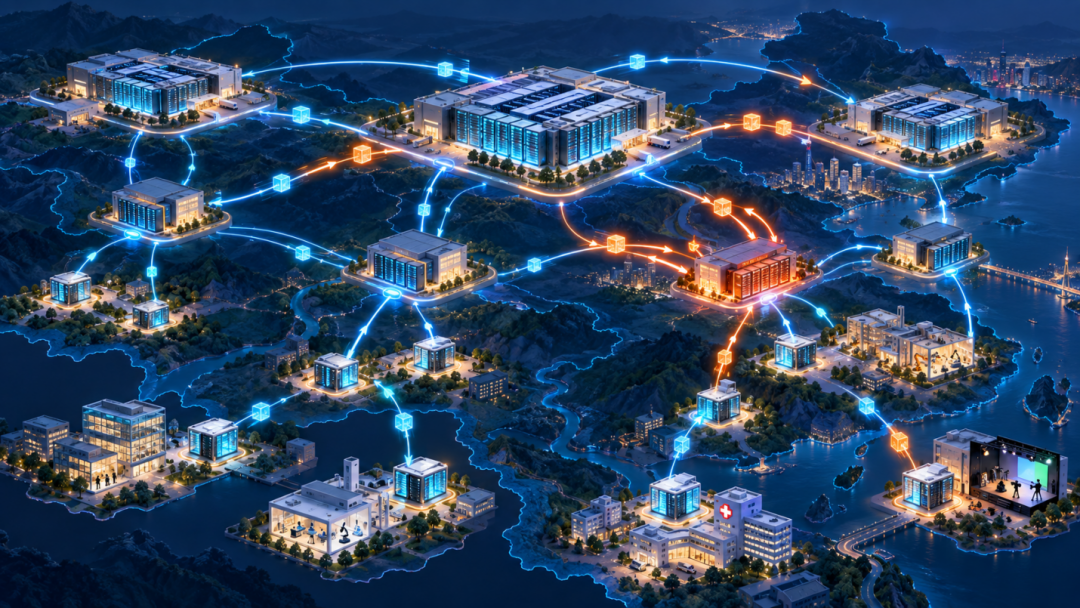
“联通星罗”先进算力调度平台正是围绕这套思路展开:通过全域算力中心、区域算力节点和属地智算枢纽的三级布局,配合算网感知、异构编排和智能调度,把区域集群、万卡集群及超万卡集群纳入统一体系,让分散的算力能够跨地域连接、集中管理,并根据业务需求灵活调用。
比如,一项模型训练任务提交后,系统发现本地集群正在高峰期排队,另一地区的算力资源却相对充足,就可以综合芯片类型、网络时延和任务需求,把任务调度到更合适的节点;等推理请求集中涌入时,再根据实时负载和缓存情况分配资源。用户看到的只是等待时间缩短,背后发生的其实是一场持续运行的“算力调度”。
当分散的算力能够像大规模物流配送一样被连接和调度,规模才有机会转化为更稳定、更高效的 AI 服务。
一条 AI 请求,如何找到合适的芯片、模型与路径先看一个具体场景:相隔约 2000 公里的内蒙古、贵州、长三角和粤港澳,分布着不同类型的国产算力芯片。过去,它们更像几支各自训练的队伍,有各自的脾气和秉性;如今,在统一调度下,这些资源可以协同完成同一个大模型的训练任务。“联通星罗”已实现四地三芯跨域混训,跨域路由时延达到亚毫秒级,综合算效比提升至 300%。
这就好像是一部大型电影的制作:有的团队负责拍摄,有的团队负责后期,有的团队负责特效。如果所有工作都挤在同一个工作室里,遇到任务高峰就只能排队;如果不同工作室之间无法共享素材,换一个团队还得重新整理格式。跨域混训要解决的,正是类似的问题:让不同地区、不同芯片上的算力能够分工协作,同时保持数据、任务和计算过程之间的衔接。
难点在于,这些算力并不处在同一个地方,也没有使用完全相同的芯片和运行环境。网络状况、芯片架构、任务类型和集群负载随时都可能变化。过去,算力资源更像散落各地的“孤岛”,模型换一个地方运行,往往还要重新适配。联通星罗的做法,是先把这些异构算力纳入同一套调度体系,再根据任务需求、资源状态和网络条件,动态决定它们如何协同工作。这样一来,算力可以像一支跨地域的制作团队,在不同地点接力完成同一项任务。

在“联通星罗”平台里,这套调度能力由两个相互配合的“调度员”共同完成:一个负责安排算力资源,另一个负责安排模型请求。
第一位负责算力。它会判断任务适合在哪个集群运行,结合芯片类型、网络时延、资源负载和任务优先级,完成集群内的资源池化与跨地域编排。这样一来,昇腾、沐曦、昆仑芯等不同架构的算力,就有机会被统一纳管,用于训练、推理和混合部署。
第二位负责词元,也就是模型生成和处理文本时不断产生的基本单元。它要判断一次请求调用哪个模型、走哪条路径,并根据负载、缓存和硬件能力进行动态调整。用户不必关心请求具体落在哪个机房、哪块芯片上,系统会尽量把它送到更合适的。
两层调度最终落到三个结果:算力可以跨地域协同,减少资源闲置;不同芯片和模型能够更顺畅地配合,提升训练与推理效率;请求还可以通过统一网关完成模型接入、流量调度、鉴权和安全控制,并得到快速响应。
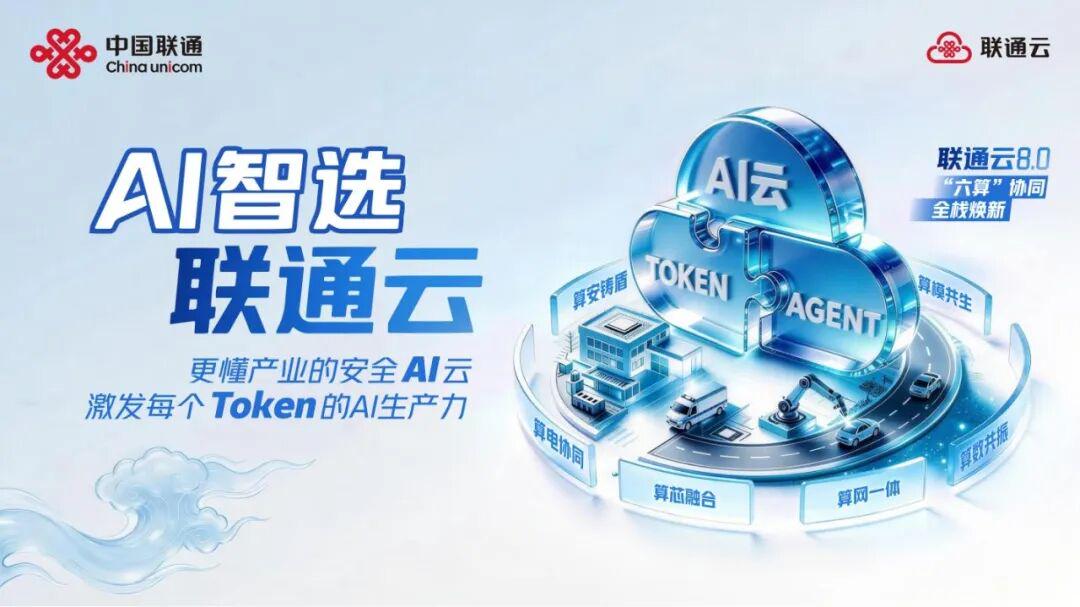
这也是“六算协同”最终要落到用户侧的三个结果:更高效的供给,通过算网一体、算芯融合和算电协同,让分散的算力更容易连接、调度和利用;更完整的 AI 生产链路,依靠算数共振、算模共生和训推服务,覆盖数据处理、模型调用、训练与推理;更可信的交付,以算安铸盾为基础,把安全机制贯穿算力基础、平台调度、模型服务和具体应用,让 AI 从生产到使用都具备相应的安全保障。
对你我这些普通用户来说,背后的路径可以很复杂,但最终体验应当更简单:响应更稳定,资源更高效,AI 服务也更容易规模化使用。
从“卖算力”到“交付稳定可用的 AI”不过,算力调度最终还是要回到具体业务里。联通云提出的“Agent+Token+AI 云”,可以把它想成一套分层的物流网络:AI 云像连接仓储、运输和配送的基础设施,负责把分散的算力、网络和存储资源组织起来;Token 像不断产生、流转和计量的“货物”,模型每完成一次生成、推理或处理任务,就会消耗相应数量的 Token;上层的智能体则像最终的配送场景,把这些能力送到写代码、整理材料、办公协同、生成视频等具体工作中。
用户不需要自己研究哪座“仓库”里放着什么芯片,也不用操心不同模型之间如何转运和适配,只需要提出需求,系统就会把合适的 AI 能力送到对应的业务场景。
金融行业的一个案例,能说明这条链路为什么重要。比如一家消费金融公司希望让 AI 协助写代码、处理日常办公和测试软件,但金融业务对成本、速度和安全都有要求:使用人数增加时不能频繁卡顿,调用多少算力要能看得清,敏感数据也不能随意离开业务系统。
“联通星罗”平台提供的方案,是在全域算力调度的基础上,为客户提供主流模型服务,并通过统一接口让不同应用调用同一套AI 能力。业务量上升时,系统可以根据需求临时调配更多算力资源,平时则按实际使用量计费。
同时,端到端加密和安全机制为数据传输与模型调用过程提供保护。依托“联通墨攻”AI内生安全能力,一方面对AI生成输出内容进行实时风险识别与拦截,杜绝有害信息生成;另一方面对AI的操作行为划定权限边界,有效防范敏感数据外泄、触发高危恶意操作等风险,保障AI在金融业务场景下合规可控运行。
这样一来,AI 就不只是“把模型装好”,而是能够真正安全的嵌入金融机构的日常流程:员工需要时可以调用,业务高峰时能够承载,使用结束后也能按照实际用量管理成本。算力、模型和应用之间的距离,就这样被压缩成了一个更容易使用的服务入口。
同样的逻辑也延伸到了政务、医疗和教育等领域。根据产品资料,联通云已服务 21 个部委、25 个省级政务云和 180 多个市级政务云,服务 2000 多家医疗云客户,助力 100 多家大型企业上云,并承建 30 多个智能算力中心。对这些客户而言,算力的价值最终要体现在业务效率、服务连续性和安全边界上,而不只是一组停留在机房里的硬件参数。
AI 下一阶段的竞争,依然会围绕模型能力展开,但真正影响用户体验的,还有模型能否被稳定地交付出来。分散的算力、模型和应用,只有经过统一组织,才能从一次次技术展示,变成企业和普通人每天都能依赖的服务。
理想的 AI 基础设施,应该像水电一样隐身于日常:用户无需关心算力来自哪里,也不用了解请求经过哪些节点,只要打开应用,就能获得稳定、可信、成本可控的结果。那时,AI 才真正从偶尔让人惊艳的“”昙花一现”,走向“长期值得依赖”。
更多信息,点击联通云官网二维码查看