9 月 20 日,Agent Memory Challenge 2026 第二期(AML Cycle 2)正式启动。赛事面向全球高校、科研机构、开源项目、独立开发者和 AI 产品团队开放。
这场围绕Agent Memory(AI Agent 长期记忆)展开的公开挑战赛,由中国图像图形学会(CSIG)主办,南京大学、浙江大学、Datawhale 以及 CSIG 企业联络与标准化工作委员会联合承办,并依托Agent Memory Leaderboard(AML)统一评测平台完成报名、评测、结果复核和榜单发布。
为什么越来越多团队开始关注 Agent Memory?因为当 AI Agent 从一次性问答走向长期工作时,真正的难题已经不只是“能不能生成答案”,而是:
Agent需要的,不只是聊天记录
设想一个持续维护软件项目的 Agent:它需要知道项目为什么采用某种设计,哪些 Bug 已经排查过,哪些方案曾经失败,以及此前确定的开发要求是否已经发生变化。
在这些场景中,Agent 需要记住的并不只是聊天记录。
它需要理解一个项目为什么采用某种设计,知道哪些 Bug 已经排查过、哪些方案曾经失败,也需要判断用户此前提出的要求是否已经发生变化,以及某条历史信息是否仍然适用于当前任务。
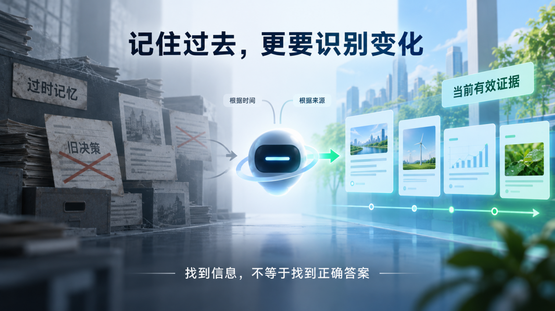
如果系统只是保存越来越多的历史内容,记忆也可能变成新的噪声来源。尤其当过去正确的信息已经被修改、替代或废弃时,简单地把旧内容检索出来,反而可能让 Agent 做出错误判断。
因此,Agent Memory 需要解决的不仅是信息召回,还包括时间和状态变化、新旧信息冲突、历史证据来源、记忆的更新与淘汰,以及一条记忆对当前任务是否仍然有效。
这也是为什么 Agent Memory 正在从一个附加功能,逐渐变成 AI Agent 基础设施中的独立研究方向。
首期AML挑战赛之后,Agent Memory 还留下了哪些问题?
首期 Agent Memory Challenge 已于 2026 年 8 月 12 日发布榜单。
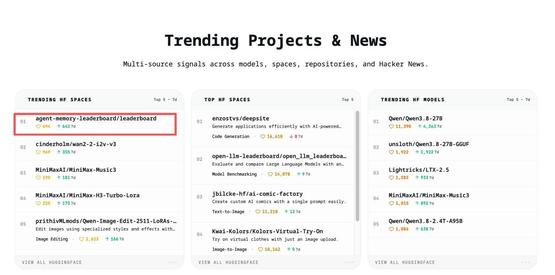
根据 AML 组委会公布的数据,首期共收到 136 支团队的报名申请,67 套代表性记忆系统完成正式评测;AML 官网累计访问量超过 30 万,官方 Hugging Face Space 也曾登上 Spaces Trending 榜首。
这些数据反映出研究界、开源社区和产业团队对 Agent Memory 统一评测的关注。但一张榜单并不能回答这个领域的全部问题。
首期评测之后,我们在海内外社区关注到,大家开始更加具体地讨论:
Agent 应该记住什么?
什么时候应该更新或删除一条记忆?
如何判断一条历史信息已经过时?
如何评价记忆对后续任务的实际帮助?
如何让比较更加公平?
这些问题也构成了 AML Cycle 2 继续推进的原因。
为什么需要 Agent Memory Leaderboard?
目前,不同 Agent Memory 系统使用的数据集、模型、提示词和评分方法并不一致。
有的系统关注事实召回,有的关注多跳推理,有的服务于 Coding Agent,还有的系统主要处理图像和文本等多模态信息。即使这些系统都公布了测试结果,成绩也很难直接横向比较。
Agent Memory Leaderboard(AML)发起 Agent Memory Challenge,正是希望建立一个更加统一、开放、可复现的评测过程。
在 AML 的评测流程中,参赛系统通过Add接口接收并写入需要记忆的内容,通过Search接口返回与问题相关的记忆或证据。
其中,Search返回的是相关记忆或证据,而不是最终答案。最终回答由 AML 平台统一的Answer环节生成,随后进入Eval、结果复核和榜单发布流程。
通过统一下游的 Answer 和 Eval 流程,AML 尽可能减少回答模型、提示词和评分口径差异带来的干扰,把评测重点更多地放在记忆系统能否返回准确、相关且适用于当前任务的证据上。
这种设计并不是要用一套标准定义所有 Agent Memory,而是希望为不同技术路线提供一个相对一致的比较边界。

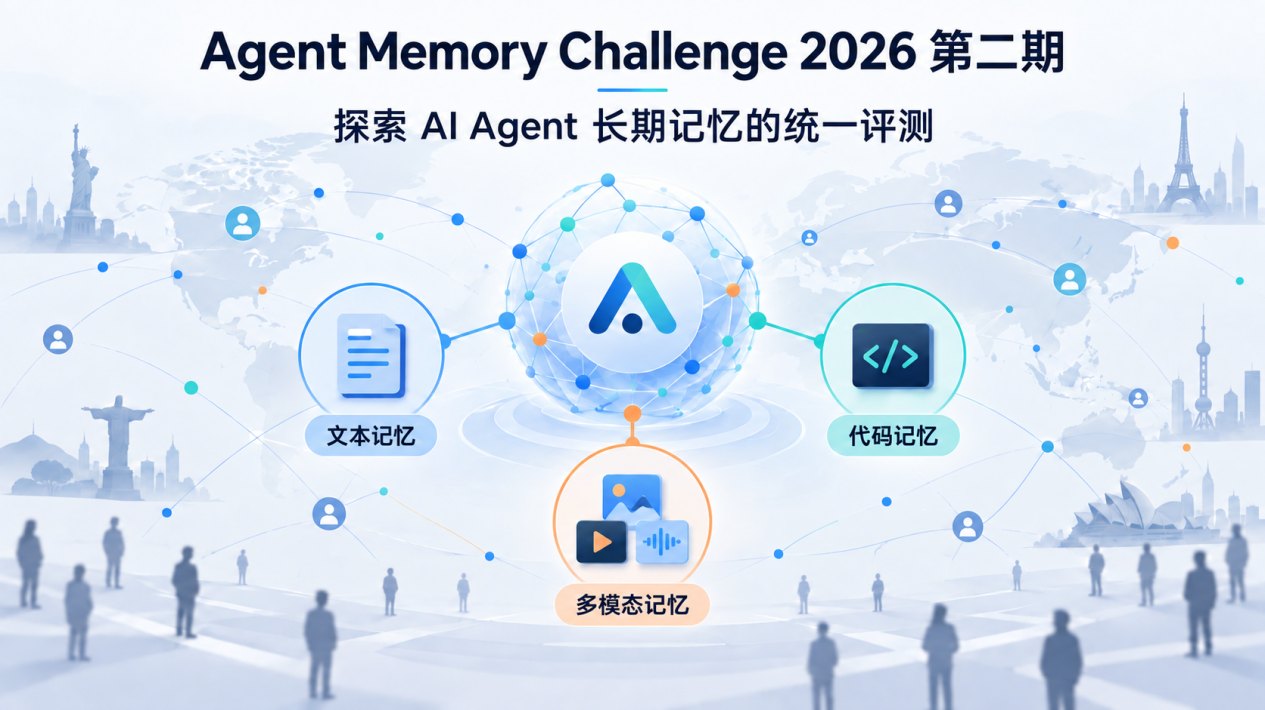
AML Cycle 2 设置三个 Agent Memory 赛道
Agent Memory Challenge 2026 第二期设置文本记忆、代码记忆和多模态记忆三个赛道,并分别设置开源方法榜和商业产品榜。
文本记忆赛道关注 Agent 在长期对话和跨会话历史中的能力,包括事实召回、关系理解、时间事件、个性化、规则执行和记忆治理。
本届还加入了 Streaming Memory 场景,测试系统能否在信息持续产生和变化的过程中,及时使用当时已经出现并仍然有效的内容,而不是只依赖一份事后整理好的静态对话档案。
代码记忆赛道面向软件工程和 Coding Agent,评测系统能否利用项目历史、开发决策、调试过程、失败方案、模块关系和测试证据,帮助 Agent 完成后续软件工程任务。
代码记忆赛道的正式评测包含 150 个软件工程任务,每个任务分别在相关历史和噪声历史条件下进行评估,共形成 300 个任务—条件组合。这样的设置可以观察 Agent 能否找到真正有帮助的工程经验,而不是被无关历史信息干扰。
多模态记忆赛道关注系统如何写入、检索和使用文本与图像信息,测试 Agent 能否建立跨模态证据之间的联系,并在后续任务中正确使用这些记忆。
三个赛道分别对应长期对话、持续软件开发和多模态信息处理等典型 Agent Memory 场景。
让 Agent Memory 变得可衡量
统一评测可以提供共同参照,但榜单成绩并不等同于系统在所有真实业务中的表现。对某个任务有效的记忆机制,在另一种信息结构、更新频率或使用场景下,未必具有相同优势。因此,对研究者而言,公开评测的价值不仅是验证方法能否提高总分,也在于识别它在哪些任务上有效、在哪些条件下容易失效。对开源项目和商业产品团队而言,分赛道的结果则有助于观察系统的能力差异,并为后续场景验证提供依据。
目前,Agent Memory Challenge 2026 第二期已经启动,面向全球高校、科研机构、开源团队、企业、个人开发者和跨组织团队开放,参赛免费。
根据AML官方所述,Agent Memory Leaderboard 的目标不是用一个排名定义所有记忆系统,而是推动 Agent Memory 走向更加公开、可比较和可复现的评测。
Agent Memory Challenge 2026 Cycle 2 已正式开启。
赛事官网:https://agentmemoryleaderboard.ai/
报名与评测入口:https://agentmemoryleaderboard.ai/evaluation
参赛规则:https://agentmemoryleaderboard.ai/rules
API 接入指南:https://agentmemoryleaderboard.ai/api-guide
赛事 GitHub:https://github.com/AML-memory/agent-memory-leaderboard